欢迎使用 omyai
从一个 API 入口开始,连接海内外 AI 模型。了解模型特长、看懂调用价格。
模型从这里开始
写代码、整理资料、构思方案、处理日常工作,AI 已经可以成为你工具箱里的一部分。真正开始使用时,你需要解决三个问题:怎么接入、选哪个模型、一次调用花多少钱。
omyapi 提供统一的模型 API 接入入口,让你在支持自定义接口的工具中,按任务选择不同模型。
为什么选择中转站
统一管理接入与账单,减少逐家注册、配置账号和支付的步骤。
按实际调用用量计费,偶尔使用其他模型,也无需额外维持月度订阅。
聊天、编程和自动化共用一套接入信息,根据任务切换合适的模型。
先分清订阅与 API。 官方聊天产品的订阅和 API 调用通常分别计费。通过中转站调用模型,获得的是接口能力;网页端的会员权益、专属功能和工具不会因此自动包含在内。实际网络可达性取决于你使用的客户端与服务地址。
一个入口,连接多家模型
接入时,先准备好这三项:
| 配置项 | 它的作用 | 如何填写 |
|---|---|---|
| Base URL | 请求发送到哪里 | https://omyai.vip/v1 |
| API Key | 用哪个令牌鉴权与计费 | 在控制台创建令牌并复制,填写到工具的密钥栏 |
| Model | 本次使用哪个模型 | 一般你使用的工具中就可以选择模型 |
海内外模型
选择模型时,先看任务,再看质量、速度与价格。下面列出各系列的代表模型和适合优先尝试的方向,方便你建立第一套模型组合。
| 模型系列 | 代表模型 | 主要侧重 | 可以从这些任务开始 |
|---|---|---|---|
| Claude | Sonnet 5.5、Opus 5.5、Fable 5.1、Haiku 5.5 | Sonnet 平衡速度与能力;Opus 侧重持续编程与知识工作;Fable 面向更复杂的推理;Haiku 侧重快速批量处理 | 代码修改、方案分析、文档整理、分类与信息提取 |
| GPT | GPT-6.1 Sol、GPT-6 Astra、GPT-6 Luna | Sol 平衡能力与成本;Astra 面向复杂推理和编程;Luna 面向成本敏感的大量任务 | 通用工作助手、代码调试、复杂问题分析、批量文本处理 |
| Gemini | Gemini 3.8 Flash、3.5 Flash-Lite、3.1 Pro(预览) | Flash 面向编程与多步工作流;Flash-Lite 侧重速度和成本;Pro 面向复杂问题 | 编程助手、多模态资料理解、自动化处理;输入类型需核对具体版本 |
| Grok | Grok 4.7 | 编程、工具调用与可调节的推理深度 | 代码任务、工具驱动的资料检索与问答;实时信息需要启用搜索工具 |
| 国产模型 | Qwen3.7 Plus、Qwen3.8 Max / Flash,以及 DeepSeek、GLM、Kimi 等系列 | Qwen Plus 平衡能力与成本,Max 侧重推理,Flash 侧重低成本;其他系列按具体版本评估 | 中文办公、内容整理、代码辅助、批量处理,可与海外模型做同题对比 |
模型信息参考:Claude 模型说明、OpenAI 模型说明、Gemini 模型目录、Grok 模型说明、阿里云百炼模型选型。以上是官方模型介绍,omyapi 的实际上架情况以控制台为准。
不知道选哪个,先按任务分工
- 日常主力: 从 GPT-6.1 Sol 或 Claude Sonnet 5.5 开始,处理写作、代码和资料分析,再根据实际输出调整。
- 复杂任务: 遇到多步推理、难定位的代码问题或重要方案,尝试 GPT-6 Astra、Claude Opus 5.5 等更强模型;需要时再测试 Claude Fable 5.1。
- 大量简单任务: 分类、短摘要、字段提取和固定格式改写,可以先试 GPT-6 Luna、Claude Haiku 5.5、deepseek-flash 等。
建议拿自己的三到五个真实任务做小样本比较,记录结果是否可用、响应耗时和单次费用。能稳定完成你任务的模型,才适合作为主力。
模型如何计费
文本模型通常按 Token 用量计费。你发送的提示词、资料和历史消息属于输入,模型生成的内容属于输出。Token 是模型处理内容的计量单位,不等同于字数,也不是按提问次数收费。
一条请求里的普通输入、输出、缓存读取分别计算,再相加。单价通常按「每 100 万 Token」给出,所以计算时还要除以 1,000,000。
在本站算费用,美元数值可以直接当成人民币理解。 平台充值 ¥1 人民币,到账 $1 平台额度。因此,后面的美元计算结果在乘过分组倍率后,数值不变,把
$换成¥,就是实际人民币成本,无需再乘美元汇率。例如平台扣费 $0.01,对应实际花费 ¥0.01。这是本站平台额度的兑换规则。
缓存读取单独按缓存价计费,不再重复计入普通输入。 对话越长、发送的资料越多、输出或推理消耗越多,都可能增加用量;缓存写入、工具调用等其他费用,以模型计费规则和使用日志为准。
下面用 GPT-6.1 Sol 的实际用量,把这套公式算一遍。
价格如何计算
先看模型的官方基准价,再乘所选分组的倍率,就能算出本次调用扣除的平台额度。下面以 GPT-6.1 Sol 和 GPT-官方满血 分组为例。
先看价格与倍率
- 充值比例:1:1。 支付 ¥1 人民币,到账 $1 平台额度;例如充值 ¥10,到账 $10 平台额度。平台按美元算出的最终扣费,直接按相同数值的人民币理解即可,无需再换汇。
- 分组:GPT-官方满血。 本例分组倍率为 0.25,按官方基准费用的 25% 结算,即四分之一。
GPT-6.1 Sol 的官方 Standard 档位单价为:普通输入 $2、输出 $10、缓存读取 $0.10 / 每 100 万 Token,适用于输入不超过 272K Token 的请求。乘 0.25 分组倍率、再按充值 1:1 换算后,对应的实际成本分别为 ¥0.50、¥2.50、¥0.025 / 每 100 万 Token。
价格来源:OpenAI 官方 GPT-6.1 Sol 定价,核对日期:2026-10-14。更长上下文和其他服务档位的单价不同,请以本次请求实际命中的计费档位为准。
用一条实际日志算一遍
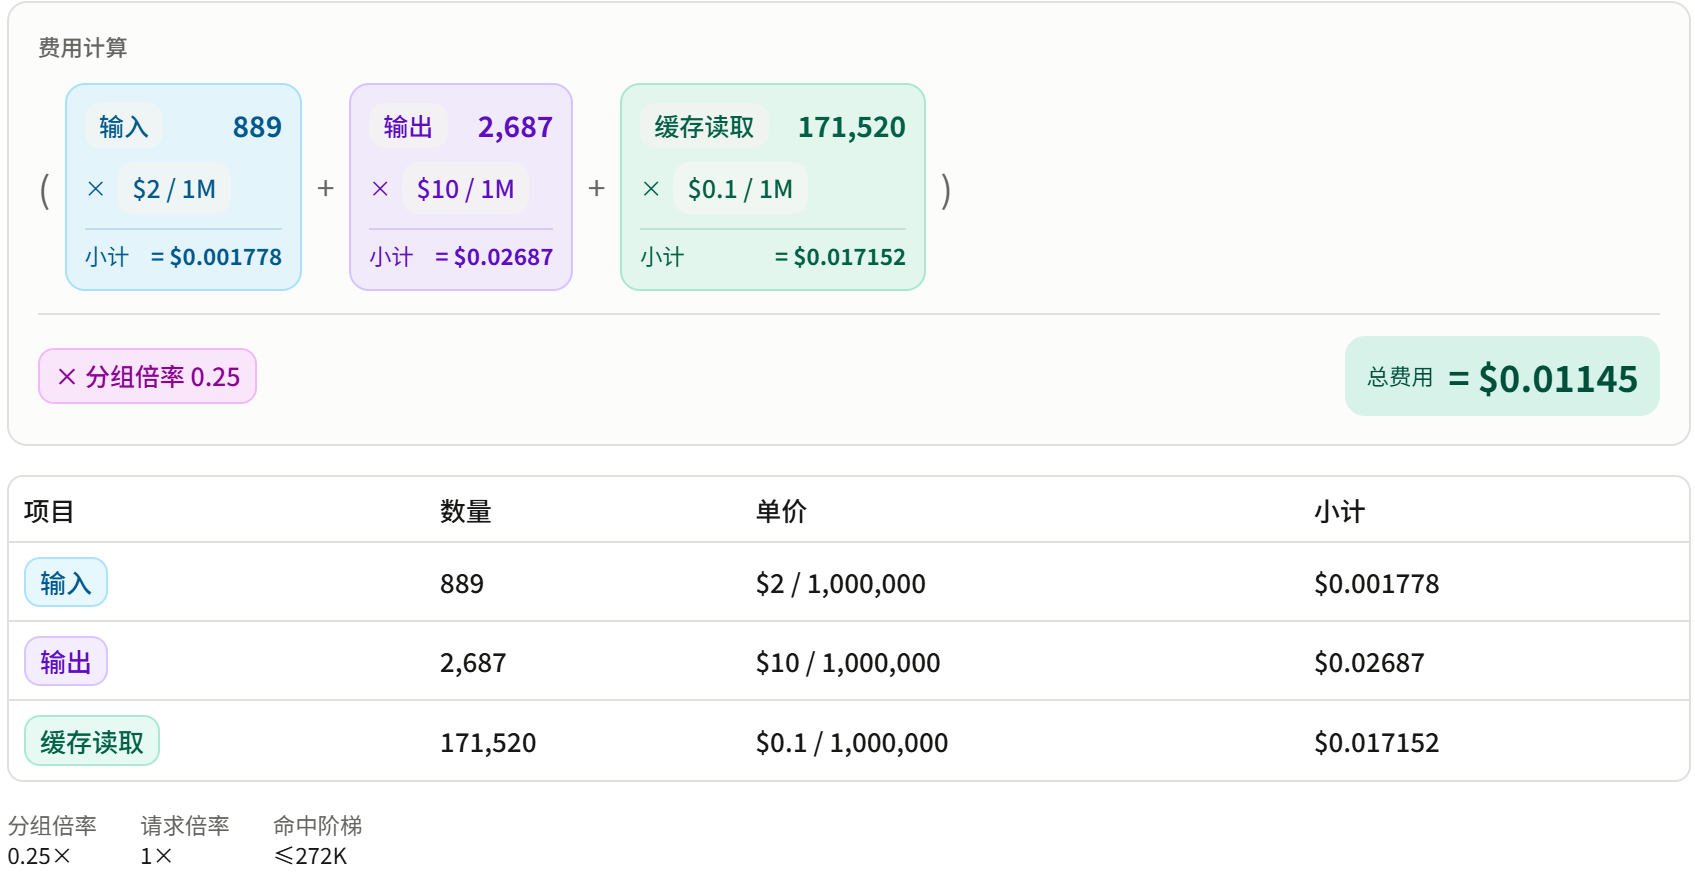
下面使用一条日志中的用量:普通输入 889 Token、输出 2,687 Token、缓存读取 171,520 Token。本例没有缓存写入、搜索等附加费用。

这次调用扣除 $0.01145 平台额度,折合实际充值成本 ¥0.01145,即 1.145 分人民币。 按完全相同的用量调用 1,000 次,实际成本为 ¥11.45。分组倍率已在扣费时计算,换算人民币成本时无需再次乘 0.25。
按本站 1:1 的充值规则,也可以全程按人民币数值计算:¥0.04580 × 0.25 = ¥0.01145。与本站未乘分组倍率的计费基准相比,少花 ¥0.03435,优惠 75%。
缓存命中部分按缓存价单独计算。 本例的 889 是不含缓存命中的普通输入;缓存读取的 171,520 Token 已单列计费,不要再按普通输入价格重复计算。如果工具显示的是总输入,需要先区分其中的缓存用量。
去 omyai 使用日志查看计费明细
登录 omyai 控制台,打开 使用日志,找到对应调用记录并点击 详情。我们提供专门的计费计算展示,会列出各项用量、单价、小计、分组倍率和命中阶梯,方便逐项核对。
日常使用无需每次手算,直接查看日志里的总费用即可。示例用于说明计算方法,实际扣费以对应日志的用量、单价、倍率与附加费用为准。